
Cómputo sin servidor: transformando el futuro de los servicios en la nube
El cómputo sin servidor, un modelo de ejecución dentro de la computación en la nube, permite a los desarrolladores de software crear y operar aplicaciones y servidores sin necesidad de gestionar ni aprovisionar la infraestructura subyacente. Bajo este esquema, el proveedor de la nube se encarga de la gestión regular de la infraestructura, tareas de mantenimiento como actualizaciones del sistema operativo y aplicación de parches, gestión de seguridad, monitoreo del sistema y planificación de capacidad. Con este modelo de pago por uso, los desarrolladores pueden adquirir servicios de backend de los proveedores de servicios en la nube basándose en el consumo real; solo se les cobra por los servicios que realmente utilizan. El objetivo principal del cómputo sin servidor es simplificar el desarrollo de código en la plataforma en la nube para que pueda realizar ciertas tareas con mayor facilidad.
Funcionamiento del cómputo sin servidor
La computación serverless libera a los desarrolladores de la gestión directa de instancias de máquinas en la nube. Permite ejecutar código en servidores en la nube sin necesidad de configurar ni mantener dichos servidores. La facturación se basa en el consumo real de recursos, a diferencia de la compra tradicional de unidades de capacidad fija. Cuando las aplicaciones residen en servidores virtuales en la nube, los desarrolladores suelen encargarse de la configuración, la instalación del sistema operativo, el monitoreo continuo y las actualizaciones de software. Sin embargo, el modelo serverless permite a los desarrolladores crear funciones en su lenguaje de programación preferido e implementarlas en una plataforma serverless. Aquí, el proveedor de servicios en la nube supervisa la infraestructura y el software, vinculando las funciones a un punto de acceso de la interfaz de programación de aplicaciones (API) y escalando las instancias de funciones bajo demanda de manera eficiente.
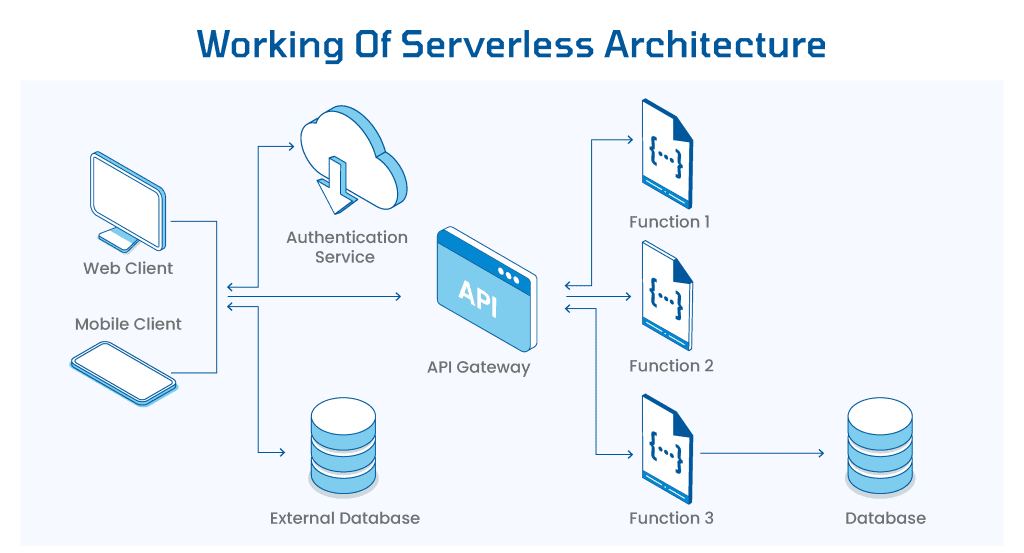
La expresión “Serverless Computing” puede llevar a muchos a pensar que significa ejecutar aplicaciones sin servidores. Sin embargo, a pesar de su nombre, la computación serverless representa un avance significativo en la tecnología de la nube. Este artículo está diseñado para desarrolladores interesados en la siguiente fase de la computación en la nube. Exploremos más en las secciones siguientes.
¿En qué se diferencia la computación serverless de otros modelos de nube?
Los tipos de despliegue en la nube implican la ubicación y la gestión de los servidores en la nube. Sin embargo, en la computación FaaS (serverless), los proveedores de nube se encargan de la provisión de recursos, eliminando la necesidad de que los desarrolladores interactúen directamente con los servidores. En contraste, otros modelos de despliegue como IaaS, PaaS y SaaS implican la gestión de servidores por diferentes partes.
IaaS: Infrastructure as a Service (IaaS) consiste en alquilar la infraestructura de TI esencial de un proveedor de nube, lo que incluye almacenamiento, sistemas operativos, redes, servidores y máquinas virtuales.
PaaS: Platform as a Service (PaaS) simplifica las operaciones para los usuarios al encargarse del mantenimiento del software, la adquisición de recursos y la supervisión de la estructura fundamental, incluido el almacenamiento, las bases de datos y los servidores. Esto permite a las organizaciones centrarse en el desarrollo, las pruebas, el despliegue y la gestión general de las aplicaciones.
FaaS (Functions as a Service): Serverless libera a las empresas de la mayoría de las tareas restantes de gestión de infraestructura que formaban parte de Platform as a Service (PaaS).
Software as a Service (SaaS): Mediante SaaS, el proveedor de nube se encarga de la operación y el mantenimiento del producto, liberando a los suscriptores de las preocupaciones sobre la gestión o el mantenimiento del servicio o la infraestructura. En esencia, SaaS funciona como un acuerdo de alquiler, donde una empresa se suscribe a una aplicación de software accesible a través de internet.
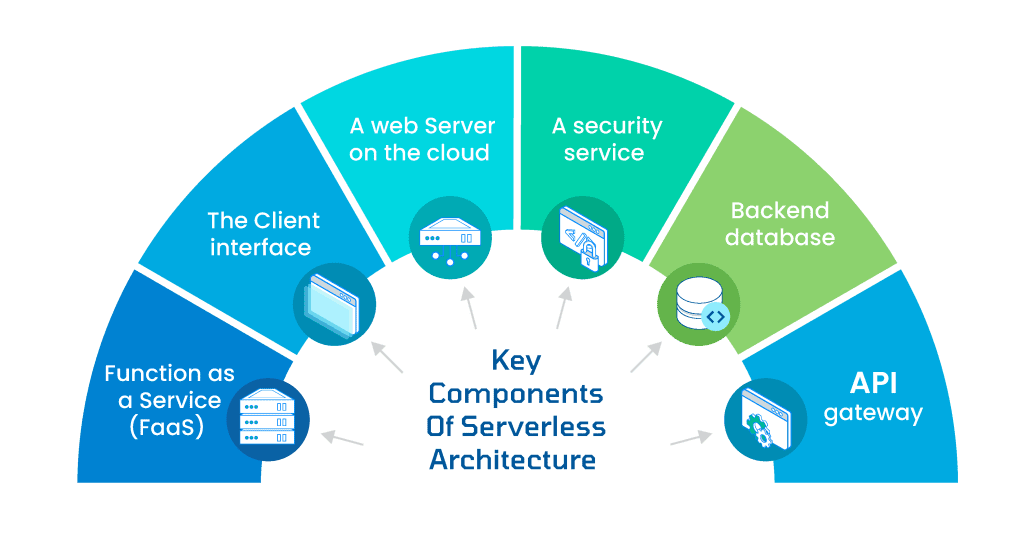
Características clave de la computación Serverless
Para cumplir con los criterios de ser una tecnología Serverless, debe atenderse a las siguientes cinco características.
Basado en eventos: el escalado, un aspecto vital de Serverless, elimina las preocupaciones sobre el escalado de su solución cuando la demanda aumenta. Su solución ajusta automáticamente su escala en respuesta a eventos, temporizadores o acciones entrantes sin su intervención directa.
No es necesario cubrir los costes de capacidad inactiva: No se le cobra por la capacidad no utilizada. Si su código no está activo, no se genera ningún cargo.
Alta disponibilidad: Las aplicaciones serverless cuentan con disponibilidad y tolerancia a fallos inherentes. No es necesario realizar consideraciones de diseño especiales, ya que los propios servicios de la aplicación garantizan estas capacidades automáticamente.
No es necesario gestionar servidores: No tendrá que configurar ni mantener servidores. No se requiere instalación, mantenimiento ni administración de software o entornos de ejecución.
Facturación por consumo: En un sistema de microfacturación, se generan cargos por cada ejecución de su código. Los proveedores suelen calcular estos costes considerando el uso de memoria y la duración de la ejecución. Por ejemplo, si su código utiliza 200MB de RAM y se completa en 3 segundos, solo se le factura por los recursos consumidos durante esa ejecución específica.
Ventajas y limitaciones de la computación serverless
Hasta ahora, hemos cubierto la computación serverless y el modelo Function as a Service (FaaS). A continuación, profundicemos en las ventajas y restricciones de la computación serverless.
Ventajas de la computación serverless
La computación serverless ofrece diversas ventajas. Exploremos algunas de ellas.
Reducción del coste operativo: Function as a Service (FaaS) utiliza entornos de ejecución predefinidos, lo que significa que la infraestructura solo se utiliza durante períodos específicos. Además, el uso compartido de estos entornos de ejecución conlleva una reducción notable en los costes operativos.
Desarrollo rápido: Al gestionar el proveedor de nube la infraestructura, los desarrolladores pueden centrarse en perfeccionar las funciones principales sin preocuparse por el mantenimiento de la infraestructura subyacente.
Eficiencia de escalado: El escalado horizontal automático y la simplificación del escalado de infraestructura (tanto hacia arriba como hacia abajo) reducen significativamente los costes de escalado en comparación con las alternativas de Plataforma como Servicio (PaaS).
Gestión operativa simplificada: FaaS ofrece un enfoque directo para desplegar y gestionar aplicaciones. Lo más importante es que acelera la transformación de sus ideas de negocio en realidad en un plazo más corto.
Limitaciones de la computación sin servidor
Aunque la computación sin servidor cuenta con varias ventajas, es esencial reconocer sus limitaciones. Examinemos estos aspectos,
Control de la infraestructura: Las arquitecturas sin servidor, supervisadas por los proveedores de nube, no ofrecen control directo sobre la infraestructura.
Operaciones de larga duración: No es ideal para operaciones por lotes prolongadas debido a las funciones de tiempo de ejecución predefinidas y los períodos de tiempo de espera impuestos por el proveedor.
Dependencia del proveedor: Cambiar entre proveedores de nube puede ser difícil debido a las dependencias de servicios específicos.
Retrasos de arranque en frío: Las estructuras basadas en eventos pueden causar retrasos en la respuesta a eventos tras un período de inactividad, lo que resulta en una respuesta inicial más lenta.
Infraestructura compartida: El uso compartido de recursos puede provocar que las aplicaciones vecinas afecten el rendimiento debido a cargas elevadas, aunque este problema no es exclusivo de las configuraciones serverless.
Desventajas
Restricciones de control: Los desarrolladores tienen un control limitado sobre la infraestructura subyacente y dependen en gran medida del proveedor de nube.
Adaptabilidad limitada: No todas las aplicaciones o cargas de trabajo se ajustan a los requisitos arquitectónicos específicos de la computación serverless.
Latencia de inicio en frío: Las funciones pueden experimentar retrasos al iniciarse si han estado inactivas, lo que afecta el rendimiento general de la aplicación.
Posible dependencia del proveedor: La dependencia de un único proveedor puede restringir la flexibilidad y dificultar la transición a otro proveedor.
En muchos escenarios, los beneficios de la computación serverless y el modelo Function as a Service (FaaS) superan estas desventajas. Sin embargo, los desarrolladores deben sopesar cuidadosamente estas consideraciones antes de optar por este enfoque.